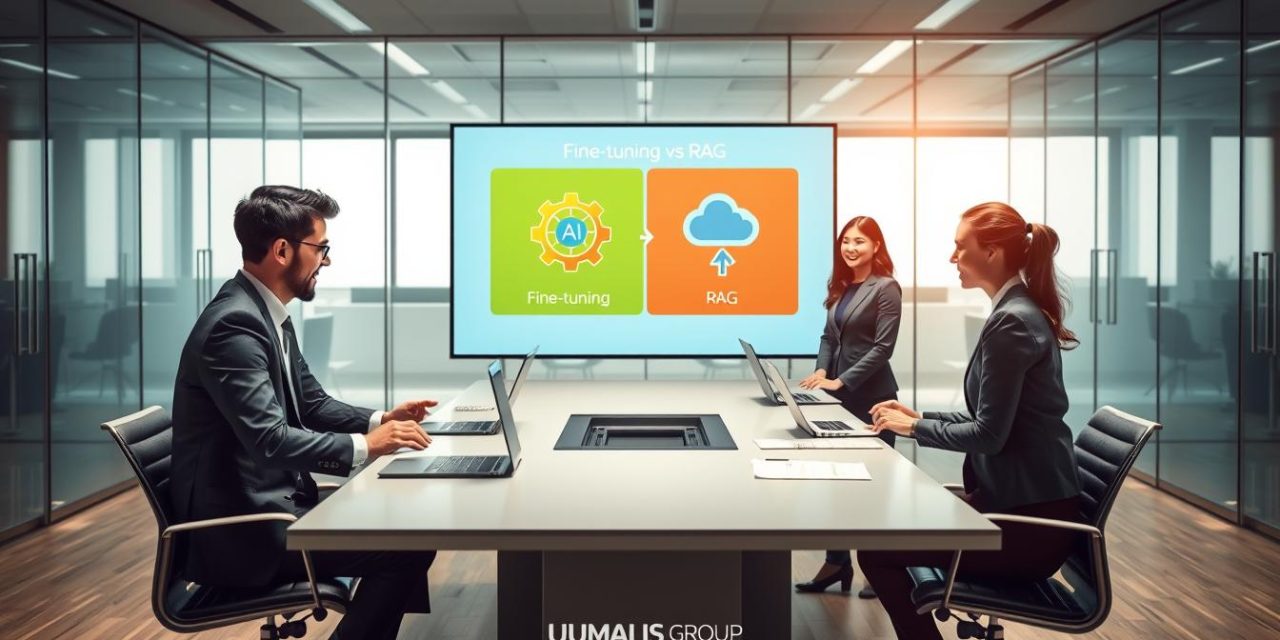
Un grand modèle de langage, ou LLM, peut produire des réponses utiles sans connaître les règles propres à chaque entreprise. Pour l’adapter à un métier, deux approches reviennent souvent : le RAG, qui recherche des informations dans des documents, et le fine-tuning, qui adapte le comportement d’un modèle.
Les repères proposés par Meta et IBM montrent qu’il ne s’agit pas de choisir un vainqueur universel. Le bon choix dépend du besoin réel. En portage salarial, le consultant doit donc traduire les attentes du client en critères concrets : fraîcheur des sources, format des réponses ou possibilité de les vérifier.
Nous expliquerons les termes techniques simplement. La génération désigne la création d’un texte, tandis qu’un prompt est la consigne donnée au système. Vous verrez aussi comment distinguer les faits établis, les hypothèses de travail et un exemple fictif.
La question qui guidera le comparatif est directe : faut-il surtout retrouver une information à jour, ou obtenir un comportement et un format précis ? Pour estimer votre activité en portage, vous pouvez consulter le simulateur de portage salarial ; son résultat dépend des hypothèses saisies et ne garantit pas un salaire.
Table of Contents
Points clés à retenir
- Le RAG et le fine-tuning répondent à des objectifs différents et peuvent être complémentaires.
- Le choix dépend du besoin métier, pas d’un classement général.
- La fraîcheur des documents et la traçabilité des réponses sont des critères utiles.
- Un prompt est une consigne qui oriente la génération de texte.
- Il est important de séparer faits vérifiés, hypothèses et exemples fictifs.
- Une estimation en portage dépend des données saisies et ne constitue pas un salaire garanti.
Comprendre ce que l’on compare : LLM, IA générative et agents
Avant de choisir une solution, il faut distinguer ses composants. Ces termes décrivent des fonctions différentes, même s’ils se retrouvent parfois dans une même application. Cette distinction aide à présenter au client un besoin clair, sans promettre plus que le système ne peut faire.
Un LLM génère des réponses à partir d’une question et de son contexte
Un LLM est un modèle de langage qui produit une réponse à partir d’une question et d’informations utiles. Pour une recherche documentaire, IBM décrit quatre étapes : la requête, la récupération d’informations, leur intégration au contexte, puis la réponse. Un prompt précise la consigne donnée au modèle.
L’IA générative désigne les systèmes qui créent du contenu
La génération peut créer du texte, résumer des documents ou formuler des réponses. Les données disponibles et l’usage prévu influencent le résultat. Il convient donc de vérifier les fonctions annoncées dans la documentation officielle.
Un agent peut enchaîner des tâches avec des outils selon un objectif défini
Un agent n’est pas seulement un LLM. Son système peut combiner une logique de traitement, des outils et un accès encadré aux données. Il peut alors organiser des tâches, comme chercher des connaissances puis préparer une synthèse. Pour vous, l’enjeu est d’expliquer le rôle de chaque composant avant de proposer une expertise.
| Élément | Rôle | Exemple d’usage |
|---|---|---|
| LLM | Produit du langage | Formuler une réponse |
| IA générative | Crée du contenu | Résumer des documents |
| Agent | Coordonne des actions | Rechercher puis synthétiser des informations |
Comparer le RAG et le fine-tuning sans les confondre
La différence tient au moment où l’on agit : pendant la recherche d’information ou pendant l’entraînement du modèle. Ce repère aide à présenter chaque approche sans promettre un résultat garanti.
Le RAG recherche des passages dans des documents au moment de la question
Cette architecture repère des passages utiles dans une base documentaire, puis les ajoute au contexte transmis au LLM. IBM décrit quatre étapes : requête, recherche, intégration des passages et réponse. La recherche sémantique peut s’appuyer sur des bases vectorielles. Meta a développé ce cadre, appelé génération augmentée par récupération. IBM date du 12 avril 2021 l’article fondateur de Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.
Le fine-tuning ajuste le modèle pour une tâche ou un comportement ciblé
L’entraînement modifie les paramètres du modèle à partir d’exemples. Des techniques comme LoRA et QLoRA peuvent réduire les ressources requises, mais les besoins en données annotées et en calcul dépendent du projet. Ce choix convient, par exemple, à une classification spécialisée ou à un style de réponse précis. Le bon cas d’usage dépend des objectifs, des sources et de la qualité des données.
| Critère | RAG | Fine-tuning |
|---|---|---|
| Action | Retrouve des connaissances | Adapte le comportement |
| Élément mobilisé | Documents et recherche | Exemples d’entraînement |
| Limite à vérifier | Pertinence des passages | Qualité des données et ressources |
Choisir entre fine tuning RAG consultant selon le besoin du client
La recommandation part d’un besoin concret, pas du nom d’une technologie. Demandez quelles informations l’application doit traiter et à quel usage elle répond. Le modèle, les données disponibles et le contexte comptent aussi. Des critères observables aident à juger les réponses sans promettre une expertise automatique.
Privilégier le RAG pour des connaissances qui évoluent et des réponses sourcées
Si le client veut interroger des documents actualisés, retrouver des informations internes ou vérifier les sources, le RAG peut convenir. Les réponses s’appuient alors sur des passages retrouvés au moment de la demande. Un prompt clair aide à préciser les éléments attendus.
Étudier le fine-tuning pour un format, un style ou une tâche spécialisée
Cette approche mérite examen si le besoin porte sur un style constant, un format donné ou une classification. Elle suppose des exemples adaptés pour l’entraînement ; le résultat dépend de leur qualité et du modèle choisi.
En portage salarial, le consultant peut présenter les options de services et de produits avec leurs limites. Tout coût reste une estimation liée au périmètre et aux hypothèses convenues, non un engagement garanti.
Suivre une méthode de cadrage claire avec un client non technique
Un échange structuré aide à transformer une attente générale en mission vérifiable. Vous pouvez avancer par étapes, puis consigner les décisions pour que l’entreprise et vous partagiez le même cadre.
Définir les questions et les utilisateurs concernés
Recueillez les questions réelles, les profils concernés et les applications visées. Reliez chaque question à un besoin précis, puis fixez le périmètre, les responsabilités et les limites du système. Un prompt d’essai peut aider à illustrer l’usage attendu.
Vérifier les sources et les exemples disponibles
Contrôlez les droits d’accès, la qualité et la fraîcheur des documents. IBM indique que leur découpage en fragments peut faciliter la recherche. Ces fragments peuvent être convertis en représentations numériques, puis stockés dans une base vectorielle. Examinez aussi les données : sont-elles cohérentes pour évaluer un modèle ou préparer son entraînement ?
Comparer les options avec des critères observables
Choisissez des tests simples : pertinence des passages, format des réponses et réaction aux informations absentes. Notez les obligations vérifiées, les hypothèses et les exemples de travail. Votre documentation peut préciser le temps, l’infrastructure et les coûts estimés. Si la mission inclut votre rémunération, consultez ce guide sur le salaire en portage salarial. Vous gardez ainsi une approche claire, sans promettre de résultat garanti.
Illustrer les arbitrages avec un cas explicitement fictif
Le scénario suivant est entièrement fictif. Il montre comment un professionnel autonome en portage salarial peut aider une entreprise à explorer ses procédures, sans raconter une mission réelle ni promettre un résultat.
Un assistant prépare des réponses à partir de procédures client
Imaginons un service qui veut retrouver les étapes d’une demande interne. Les documents sont découpés en fragments, puis représentés dans une base vectorielle. Selon le principe RAG décrit par IBM, le système recherche des passages utiles et les ajoute au prompt avec le contexte de la question. La réponse peut alors citer ses sources et fournir des connaissances à jour.
Comparer les sources et le format métier attendu
Une autre version pourrait suivre le style et le format attendus par le service, grâce à des exemples d’entraînement. Cela ne garantit pas l’exactitude des informations : le modèle doit toujours s’appuyer sur des éléments vérifiés. Le consultant peut tester les étapes de recherche et d’intégration avec des questions préparées, puis noter les écarts.
Dans ce cas fictif, les données et le document sont inventés. Le client valide les critères de support et de confidentialité. Pour développer votre réseau professionnel, découvrez aussi ces opportunités de réseautage en portage salarial.
| Point comparé | Réponse avec sources | Format métier |
|---|---|---|
| Priorité | Informations retrouvées | Style et structure attendus |
| Vérification | Contrôler les passages cités | Vérifier chaque fait séparément |
Envisager une architecture hybride lorsque les besoins sont distincts
Certains projets demandent à la fois des faits récents et des réponses au format attendu. Une architecture hybride peut alors associer le RAG, qui cherche des informations à jour dans des documents, et le fine-tuning, qui adapte le comportement du modèle. Cette approche reste à étudier au cas par cas : elle n’est pas nécessaire pour chaque usage.
Séparer les connaissances du comportement attendu
Demandez au client de distinguer deux besoins : retrouver les bonnes sources pour chaque question, puis produire des réponses selon un style ou un format précis. Le prompt peut guider la génération, tandis que le système de recherche apporte les connaissances utiles aux applications.
RAFT est une approche hybride qui associe un modèle affiné à une architecture de récupération. Elle peut convenir à certains contextes, mais demande d’examiner les données disponibles, la complexité et les responsabilités de maintenance.
« Une solution claire sépare ce qui doit rester à jour de la façon dont le modèle doit répondre. »
Avant de combiner plusieurs techniques, évaluez le temps nécessaire et les critères de test. Documentez les sources et le rôle de chaque composant. Vous pourrez ainsi expliquer les arbitrages au client avec clarté et prudence.
Évaluer les coûts, le temps et la maintenance sans promettre de résultat
Le budget dépend des choix techniques, du volume traité et du suivi attendu. Pour l’entreprise, une estimation utile détaille ses hypothèses. Elle ne garantit ni résultat ni retour sur investissement.
Chiffrer la recherche documentaire et son infrastructure
Pour une base de documents, comptez la préparation, l’indexation et la recherche. Ajoutez l’exécution du modèle et la mise à jour des sources, parfois au jour le jour. Ces postes influent sur le coût et les coûts de maintenance.
- Notez le volume de données, l’infrastructure disponible et l’usage prévu.
- Suivez le temps requis pour maintenir les documents et les services associés.
Estimer les besoins liés à l’entraînement
L’entraînement demande des données de qualité, des compétences et des ressources de calcul. LoRA et QLoRA sont des techniques à comparer selon le cas, le style et les tâches visés. IBM décrit le PEFT comme une méthode qui ajuste certains paramètres du modèle. Elle n’actualise pas tous ses paramètres.
Oracle annonce des superclusters allant jusqu’à 65 536 GPU. Ce chiffre décrit une capacité maximale de son offre, pas un besoin standard. Le consultant peut documenter les produits, les services et les hypothèses, puis revoir l’estimation avec le client. Les besoins et les coûts évoluent selon le volume de données et l’infrastructure retenue.
Encadrer les données, la confidentialité et les règles applicables
La protection des informations commence par des choix simples et vérifiables. Elle aide l’entreprise à mieux maîtriser les usages du système, sans confondre une mesure technique avec une garantie juridique.
Contrôler les accès et limiter les données utilisées
Examinez chaque base de documents : qui peut y accéder, et pour quel besoin ? IBM recommande d’intégrer des contrôles d’accès aux pipelines de données selon les rôles. Limitez les données personnelles au périmètre défini. Testez aussi si un modèle de langage (LLM) peut révéler des informations à une personne non autorisée.
- Vérifiez les droits, les applications concernées et les réponses produites par le système.
- Consignez les choix d’architecture et les données réellement utilisées.
Vérifier les règles auprès des sources officielles
Les règles peuvent évoluer. Consultez les pages à jour de la CNIL et de la Commission européenne. Pour les questions juridiques ou sociales, vérifiez aussi Service-Public, Légifrance et l’Urssaf. Notez la date et les sources consultées ; distinguez les obligations vérifiées des hypothèses de l’entreprise. Pour le cadre professionnel, découvrez aussi le portage salarial dans le service informatique.
Une vérification datée rend les arbitrages plus clairs, sans promettre une conformité automatique.
Checklist du consultant autonome en portage salarial avant de recommander une solution
Une checklist partagée aide à cadrer votre expertise et à protéger la relation avec l’entreprise. Avant toute recommandation, consignez le besoin, les personnes concernées et les décisions à valider.
Poser un cadre et des critères de test
Écrivez le périmètre, les responsabilités, les limites du système et les applications visées. Définissez des tests à partir de questions réelles et de documents disponibles. Pour un cas de recherche, examinez chaque étape : requête, récupération, intégration au contexte, puis réponses. Évaluez aussi la classification, le style, le support et la mesure attendue.
Séparer les faits des hypothèses
Dans la documentation, distinguez les obligations vérifiées, les hypothèses de travail et chaque exemple fictif. Précisez les données utilisées, la méthode, l’infrastructure, le temps estimé et le coût éventuel. Comparez la base documentaire, l’entraînement du modèle et une combinaison selon le besoin. LoRA, QLoRA et PEFT peuvent être étudiés selon les ressources disponibles.
Tracer les sources et les arbitrages
Datez les informations réglementaires et notez la source exacte. Consultez Service-Public, Légifrance, l’Urssaf, la CNIL ou la Commission européenne selon le sujet. Présentez les produits et services retenus avec leurs limites.
« Un arbitrage documenté rend la décision plus claire, sans garantir le résultat. »
Archivez les sources, les choix et les critères de mesure. Indiquez que toute estimation reste liée aux données et aux hypothèses retenues.
| Point à vérifier | Élément à consigner | Repère utile |
|---|---|---|
| Périmètre | Utilisateurs et limites | Accord de l’entreprise |
| Tests | Recherche et format | Questions représentatives |
| Arbitrage | Sources et estimations | Date et hypothèses |
Conclusion
Le bon choix dépend du besoin du client, des données disponibles, du format attendu et du suivi à prévoir. Le RAG ajoute des documents utiles, tandis que le fine-tuning adapte un modèle à une tâche ou à un style précis. Aucune approche ne garantit, à elle seule, des réponses exactes.
Pour une génération de texte fondée sur un modèle de langage, le consultant en portage gagne à consigner ses critères, ses sources et ses hypothèses. Vous pouvez aussi valoriser votre expertise en portage salarial en présentant clairement les limites de votre recommandation.
Les coûts et les performances dépendent du périmètre retenu ; aucun revenu ni retour sur investissement n’est garanti. Pour estimer votre revenu selon vos propres hypothèses, utilisez le simulateur de portage salarial : son résultat reste une estimation, pas un salaire garanti.
FAQ
Comment expliquer simplement le rôle d’un LLM à un client ?
Un LLM est un modèle de langage qui produit une réponse à partir d’une question et de son contexte. Il peut aussi créer ou classer du contenu, mais ses réponses doivent être vérifiées selon l’usage prévu.
Quelle est la différence entre le RAG et le fine-tuning ?
Le RAG recherche des passages dans la documentation au moment de la question. Le fine-tuning adapte un modèle à une tâche, à un format ou à un style. L’un apporte des connaissances, l’autre ajuste le comportement.
Quand privilégier la recherche documentaire ?
Choisissez cette approche si les informations changent souvent ou si le client attend des réponses appuyées par des sources. La qualité dépend alors des documents, de leur mise à jour et de la recherche effectuée.
Quand le fine-tuning peut-il être pertinent ?
Étudiez cette option si le système doit suivre un format précis, adopter un style stable ou réaliser une tâche spécialisée. Il faut disposer d’exemples de qualité et mesurer les résultats avant tout déploiement.
Comment cadrer le besoin avec un client non technique ?
Commencez par les questions à traiter, les utilisateurs concernés et les réponses attendues. Vérifiez ensuite les données disponibles, les limites du service et les critères de test. Cette méthode aide à comparer les options sans jargon.
Pouvez-vous donner un exemple fictif de choix d’architecture ?
Dans un cas fictif, une entreprise veut interroger ses procédures internes. Une recherche documentaire peut fournir des réponses avec des passages cités. Si le système doit aussi respecter un format métier précis, il faut tester séparément cet aspect.
Peut-on combiner recherche documentaire et adaptation du modèle ?
Oui. Une architecture hybride peut utiliser des documents à jour pour les faits et ajuster le modèle pour la forme des réponses. Ce choix ajoute toutefois des éléments à tester et à maintenir.
Quels coûts et délais faut-il prévoir ?
Évaluez l’indexation, la recherche, l’infrastructure et le temps consacré à la maintenance. Pour l’entraînement, tenez aussi compte des exemples requis, des compétences et des ressources de calcul. Le coût dépend du cas et du niveau de service attendu.
Quelles précautions prendre avec les données du client ?
Limitez les données personnelles utilisées et contrôlez les accès aux documents. Vérifiez les règles applicables auprès de la CNIL, de la Commission européenne et de sources officielles à jour. Documentez aussi les choix de sécurité.
Que doit vérifier un consultant indépendant avant de recommander une solution ?
Clarifiez le périmètre, les responsabilités, les limites et les critères de mesure. Distinguez les obligations vérifiées des hypothèses, puis présentez les sources consultées. Vous pourrez ainsi expliquer chaque arbitrage avec transparence.